
Replication Lag Alarmından Müdahaleye: Eskalasyon Runbook’u
Replica gecikmesi alarmı çaldığında panikle parametre değiştirmek yerine kontrollü müdahale: teyit, etki analizi, teşhis, eskalasyon, eylem ve toparlanma.
▸Kısa Açıklama ve Yönetici Özeti
PostgreSQL replikasyon gecikmesi (replication lag) için tek bir evrensel saniye veya bayt eşiği yoktur. Replikasyon sağlığını operasyonel bir güvenilirlik sürecine dönüştürmenin ilk kuralı, altyapı metrikleri ile kullanıcı deneyimi (SLO) hedeflerini birbirinden ayırmaktır.
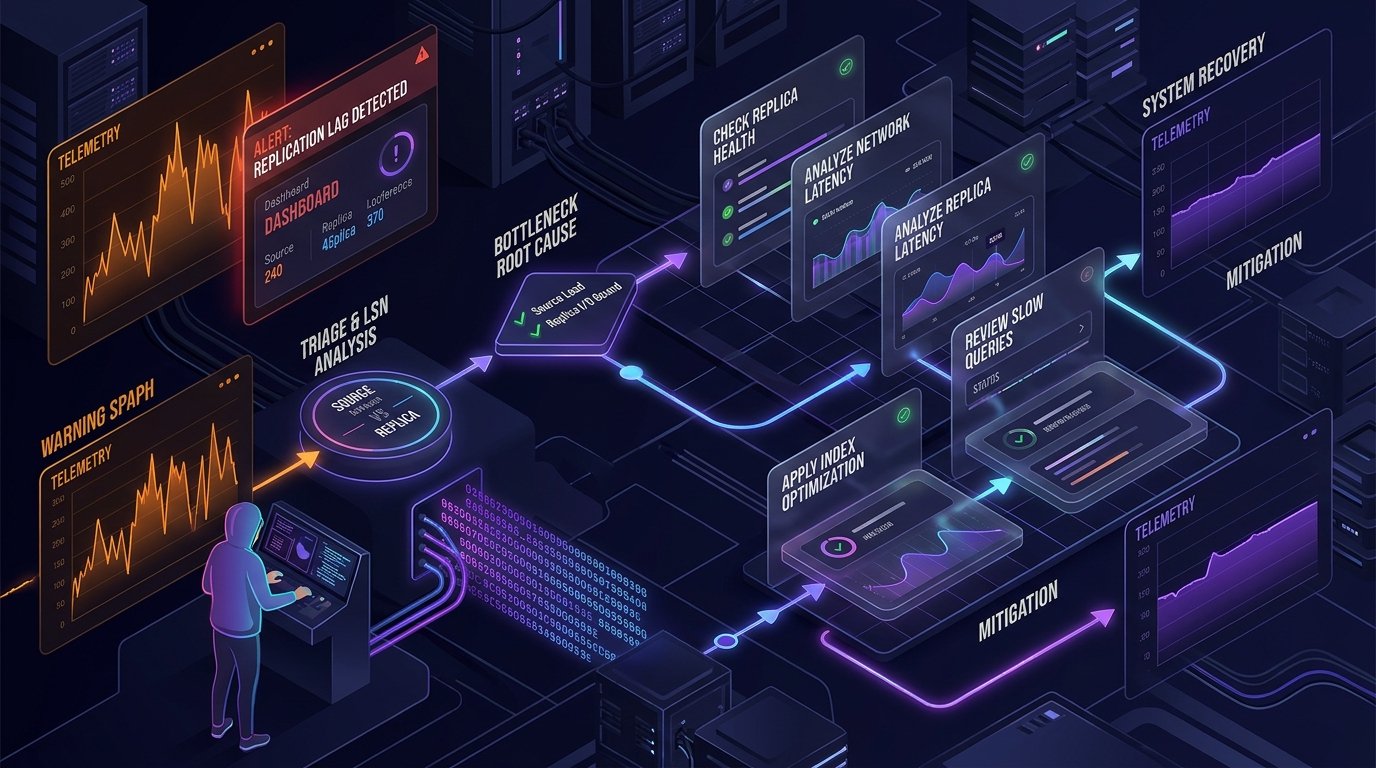
Bir lag grafiği yükseldiğinde panikle parametre değiştirmek veya replica'yı plansız yeniden başlatmak yerine; ölçümü doğrulayan, iş etkisini belirleyen, nöbetçi eskalasyonunu yöneten ve toparlanmayı kanıtla belgeleyen bir müdahale protokolü işletilmelidir.
Bu runbook şu temel soruyu yanıtlar:
▸1. Kullanıcı Etkisi (SLO) ile Altyapı Metriklerinin Ayrımı
Replikasyon gecikmesinde en sık yapılan SRE hatası, ham bir altyapı metriğini (örneğin replay_lag_bytes > 50MB) doğrudan kullanıcı odaklı bir SLO (Hizmet Seviyesi Hedefi) olarak tanımlamaktır.
| Boyut | Altyapı Sinyali (Infra Metric) | Kullanıcı / Hizmet Seviyesi Etkisi (SLO) |
|---|---|---|
| Kapsam | LSN bayt açığı, flush/replay gecikmesi, TCP soket tamponu | Kullanıcının son yazdığı kaydı okuma havuzunda görebilme süresi (Read-After-Write Consistency) |
| Ölçüm Yeri | pg_stat_replication, postgres_exporter, OS I/O sayaçları | Uygulama logları, API yanıt süreleri, analitik veri tazeliği pencereleri |
| Yorumlama | Primary yoğun bir batch çalıştırdığında bayt açığı geçici olarak büyüyebilir; ancak kullanıcı okumaları etkilenmeyebilir. | Raporlama replica'sında 30 dakikalık gecikme kabul edilebilirken, e-ticaret sepet okuma replica'sında 2 saniyelik gecikme SLA ihlalidir. |
| SRE Kuralı | Altyapı metriği erken uyarı ve teşhis içindir; doğrudan müşteri SLO'su olarak kullanılmaz. | Müşteri SLO ihlali, alarmın önceliğini anında P1/Kritik seviyeye yükselten temel tetikleyicidir. |
▸2. Örnekleme Sıklığı ve Alarm Değerlendirme Pencereleri (`for: 5m`)
Veritabanına gelen ani batch yazma işlemleri (örneğin gece toplu faturalama veya tablo yeniden indeksleme) WAL üretim hızını geçici olarak fırlatır. Bu geçici dalgalanmalar (spikes) birkaç dakika içinde kendiliğinden kapanır.
- Spike (Geçici Dalgalanma): WAL açığı 2 dakika boyunca 100 MB'a çıkar, ardından replay süreci arayı kapatır ve açık 0'a iner. Bu bir arıza değildir.
- Sustained Degradation (Sürekli Bozulma): WAL açığı 5 dakika boyunca sürekli artar, standby I/O doygunluğa ulaşır veya replay bir lock nedeniyle takılır. Bu müdahale gerektiren bir olaydır.
for: 5m (en az 5 dakikalık süregelen ihlal) değerlendirme penceresi zorunlu tutulmalıdır. Tek bir örnekleme anında eşiği aşan geçici batch yazmaları için nöbetçiyi uyandırmak (alert flapping), on-call yorgunluğuna ve gerçek krizlerin gözden kaçmasına yol açar.▸3. Kritik Ayrım: Eksik Metrik / Kopuk Bağlantı ile Rölantideki Primary
Alarm motorunuzun veri eksikliği ve rölanti durumundaki davranışı, yanlış alarmları önlemede belirleyicidir:
#### A. Eksik Metrik veya Kopuk Bağlantı (absent()) Replica çöktüğünde veya ağ koptuğunda exporter hedefi scrape edemez veya pg_stat_replication satırı kaybolur.
- Hata: Metrik gelmediğinde sistemin bunu "0 bayt lag" olarak yorumlaması ve göstergelerin yeşile dönmesi.
- Doğru Uygulama: Prometheus'ta
absent(pg_stat_replication_bytes)veyaup{job="postgres"} == 0kuralıyla "Telemetry Loss / Unknown State" alarmı üretilmeli ve bu durum gecikmeden bağımsız acil altyapı olayı olarak ele alınmalıdır.
#### B. Rölantideki Primary ve pg_last_xact_replay_timestamp Tuzağı Primary sunucuda hiçbir yazma işlemi yapılmadığında (gece veya test ortamında), standby üzerinde replay edilecek yeni işlem commit'i oluşmaz.
- Bu durumda
now() - pg_last_xact_replay_timestampifadesi saatlerce büyüyebilir! - Hata: Sistemin rölantideki veritabanı için "Replikasyon 4 saattir gecikiyor!" alarmı üretmesi.
- Doğru Uygulama: Zaman tabanlı gecikme alarmı, yalnızca primary üzerinde aktif LSN ilerlemesi varken (
pg_current_wal_lsn() != replay_lsn) devreye girmelidir. Bayt farkı 0 ise zaman farkı ihmal edilmelidir.
▸4. Warning ve Critical Alarm Seviyeleri Gerekçelendirmesi
| Seviye | Koşul & Gerekçe | Beklenen Müdahale Süresi | İlk Yönlendirme |
|---|---|---|---|
| Warning (Uyarı) | LSN bayt açığı > 64 MB ve for: 5m devam ediyor. Veritabanı çalışıyor, kullanıcı okuma SLO'su henüz ihlal edilmedi; ancak birikim trendi yukarı yönlü. | 30 dakika içinde inceleme | L1 SRE / Nöbetçi Mühendis |
| Critical (Kritik) | LSN bayt açığı > 500 MB veya for: 15m süresince büyüyor; VEYA primary disk doluluğu > %85 (slot disk baskısı); VEYA müşteri okuma tazeliği SLO'su ihlal edildi. | 5 dakika içinde anında müdahale | Nöbetçi Kıdemli DBA & Incident Commander |
| Telemetry Loss | Replica'dan 3 scrape boyunca (> 45s) veri alınamıyor veya node pg_stat_replication görünümünden düştü. | 5 dakika içinde inceleme | Platform / NetOps & DBA |
▸5. Sorumluluk, Eskalasyon ve Müdahale Protokolü (7 Adım)
- 1Sahiplenin (Acknowledge): Olay kaydını açın. Slack/incident kanalında sorumluluğu üstlendiğinizi belirtin.
- 2Ölçümü Doğrulayın (Telemetry Check): Son başarılı scrape zamanını, node'un gerçekten standby olup olmadığını ve bakım takvimini teyit edin.
- 3Kullanıcı Etkisini Belirleyin (Impact Triage): Kullanıcılar eski veri görüyor mu? Primary üzerinde commit tıkanması var mı? Diğer replica'ların durumu nedir?
- 4Darboğazı Ayırın (Handoff to DBA Guide): LSN bayt açığının hangi aşamada (gönderim, aktarım, flush, replay) biriktiğini tespit etmek için DBA Guide tanı protokolünü başlatın.
- 5Kanıta Göre Eskale Edin (Escalation Matrix):
- Ağ/soket gecikmesi -> Ağ / NetOps Mühendisliği
- Standby disk I/O doygunluğu -> Bulut / Altyapı Platform Ekibi
- Replay lock çakışması / Uzun sorgu -> Kıdemli DBA
- Kullanıcı SLO ihlali -> Incident Commander & Ürün Sahibi
- 1Kontrollü Eylem (Decision Gate): Trafik yönlendirme veya sorgu sonlandırma adımlarını onaylı yürütün.
- 2Toparlanmayı Doğrulayın (Verification): Metriklerin sıfıra indiğini ve okuma tutarlılığını doğrulayıp olayı kapatın.
▸6. Paylaşılan Laboratuvar Kanıtı (DBA Guide Docker Lab)
Bu triad içerik ailesi, DBA Guide üzerinde izole Docker ortamında çalıştırılan tekrarlanabilir laboratuvar testi (npm run test:lag) sonuçlarına dayanmaktadır:
- Laboratuvar Ortamı: Primary (
dbg-lag-pri-c10, port 55440) ve Standby (dbg-lag-stb-c10, port 55441) izole ağda çalıştırılmıştır. - Enjekte Edilen Bozulma: Standby üzerinde
SELECT pg_wal_replay_pause();komutuyla replay kasıtlı olarak duraklatılmış ve primary üzerinde 500 satırlık yazma trafiği üretilmiştir. - Ölçülen Kanıt:
- Gönderim (
sent_lsn), Ağ (write_lsn) ve Disk (flush_lsn) bayt açıkları 0 bayt kalmıştır. - Replay bayt açığı tam olarak 498.664 bayt (~487 KB) seviyesine tırmanmıştır.
- SRE izleme katmanı bu senaryoda ağ veya primary sorunu aramak yerine doğrudan "Standby Replay Stalled" tanısı koymalıdır.
- Toparlanma: Replay serbest bırakıldığında (
SELECT pg_wal_replay_resume();), 498 KB'lık birikim 1.15 saniye içinde tamamen eritilmiş ve 500 satırlık veri tutarlılığı her iki düğümde eşitlenmiştir.
▸7. Bu İlk Pakette Otomatik Failover Kesinlikle Yok!
▸8. Olay Durum Güncelleme Şablonu
Nöbetçi mühendis, olay kanalında her 15 dakikada bir şu şablonla durum güncellemesi geçer:
[HİZMET]: Veritabanı Okuma Havuzu / [REPLICA]: db-replica-02
DURUM: İnceleme Devam Ediyor (P2 - Warning)
ÖLÇÜM TAZELİĞİ: Son scrape 12 saniye önce (Güvenilir)
GÖZLENEN AÇIK: Replay lag 180 MB (for: 8m, artış eğiliminde)
KULLANICI ETKİSİ: Raporlama panellerinde 4 dk gecikme; canlı API etkilenmedi.
DARBOĞAZ AŞAMASI: Standby Replay (Sent/Write/Flush farkı 0 bayt)
YÜRÜTÜLEN EYLEM: Standby üzerinde replay engelleyen uzun analitik sorgu DBA tarafından inceleniyor.
SORUMLU: @sre-oncall (Teknik destek: @dba-oncall)
BİR SONRAKİ GÜNCELLEME: 14:30 TSİ▸9. Toparlanma Doğrulama ve Olay Kapatma Kriterleri
Olay, yalnızca alarm pager'ı sustuğu için kapatılamaz. Kapatma için şu 5 kriterin tamamı sağlanmalıdır:
- 1LSN Eşitlenmesi:
replay_lag_bytesdeğerinin 0'a indiği ve en az 10 dakika boyunca kararlı kaldığı doğrulanmalıdır. - 2Telemetri Tazeliği: Scrape zaman damgasının güncel olduğu (
< 30s) ve collector hatalarının bulunmadığı görülmelidir. - 3Primary Disk ve Slot Güvenliği: Primary üzerindeki disk kullanım oranının normal seviyeye döndüğü ve WAL birikiminin tahliye edildiği teyit edilmelidir.
- 4Kullanıcı Doğrulaması: Etkilenen uygulama servisi veya analitik veri akışının güncel veriyi okuduğu doğrulanmalıdır.
- 5Geçici Müdahalelerin Temizliği: Olay sırasında yönlendirilen okuma trafiği veya açılan alert silences (susturmalar) kaldırılmalıdır.
▸10. Olay Sonrası Aksiyonlar (Postmortem Takibi)
| İnceleme Bulgusu | Kalıcı Önleyici Aksiyon | Kabul Kanıtı |
|---|---|---|
| Replay uzun rapor sorgusu yüzünden kilitlendi | max_standby_streaming_delay parametresini ve rapor sorgularının zaman aşımını gözden geçirmek | Staged testte sorgunun belirlenen sürede sonlanması |
| Telemetri kaybı fark edilmedi | Prometheus'a absent() ve up == 0 eksik metrik alarmları eklemek | Exporter durdurulduğunda P1 alarmının çalması |
| Rölanti veritabanında sahte alarm çaldı | Zaman bazlı alarm kuralına bayt farkı kontrolü koşulunu eklemek | Yazma olmayan gecede alarm üretilmemesi |
| Teknik teşhis 30 dakikadan uzun sürdü | DBA Guide teşhis runbook linkini doğrudan Alertmanager bildirim şablonuna eklemek | Bir sonraki tatbikatta runbook'a tek tıkla erişim |
▸Kaynaklar ve İlgili Belgeler
▸Replikasyon Sağlığı Ortak Triad Bağlantıları
Bu rehber, üç siteli Replikasyon Sağlığı Triad serisinin Olay Yönetimi ve Güvenilirlik ayağını oluşturur:
- Teknik Teşhis ve Terminal Runbook'u: LSN farklarını salt okunur SQL sorgularıyla adım adım ayrıştırmak ve izole Docker tatbikatını çalıştırmak için DBA Guide: PostgreSQL Replication Lag: Darboğazı Adım Adım Teşhis Etme.
- Gözlem Aracı Seçimi ve Metrik Matrisi: Exporter, Prometheus, Alertmanager ve PMM 3 araçlarını değerlendirmek için dataxtools: Replication Lag İzleme: Araçlarda Hangi Özellikleri Aramalısınız?.
Replikasyon Olay Yönetimi & Eskalasyon Deneyiminizi Paylaşın
Üretim ortamınızdaki replikasyon alarmlarını, eskalasyon süreçlerinizi ve müdahale deneyimlerinizi paylaşarak sektör benchmark'larına katkıda bulunun.
Tamamlayıcı Ekosistem İçerikleri: PostgreSQL Replikasyon Gecikmesi (Replication Lag): Teşhis, Araç Seçimi ve Olay Eskalasyonu
Aynı mühendislik konusunu farklı açılardan (teşhis, araç seçimi, olay yönetimi) ele alan diğer dataiotech yayınları:
PostgreSQL Replication Lag: Darboğazı Adım Adım Teşhis Etme
Replica geriden geliyor. Sorun WAL üretiminde, gönderimde, aktarımda veya replay aşamasında mı? Salt okunur kontrollerle önce gecikmenin hangi aşamada biriktiğini bulun.
Replication Lag İzleme: Araçlarda Hangi Özellikleri Aramalısınız?
postgres_exporter + Prometheus + Grafana ve Percona PMM 3: Ölçüm güvenilirliği, boşta sistem davranışı ve pilot test planı.
Bu mimariyi üretimde test etmek ister misiniz?
DataOpsphere CI/CD şablonlarını ve Docker Compose ortamlarını kopyalayıp hemen çalıştırabilirsiniz.